Robotics & AI System
Data worker management + Tool labelling dữ liệu
Trong bài viết này
Giới thiệu nền tảng Data Worker & Gán nhãn AI
Nền tảng Data Worker Management & AI Labelling là giải pháp toàn diện do Naiscorp phát triển nhằm giải quyết triệt để khâu thu thập, chuẩn hóa, gán nhãn dữ liệu đa phương thức và quản trị lực lượng Data Worker quy mô lớn. Hệ thống cung cấp không gian làm việc chuyên nghiệp, linh hoạt cho mọi bài toán từ thị giác máy tính (Computer Vision), xử lý ngôn ngữ tự nhiên (NLP) đến tinh chỉnh mô hình ngôn ngữ lớn (LLM RLHF).
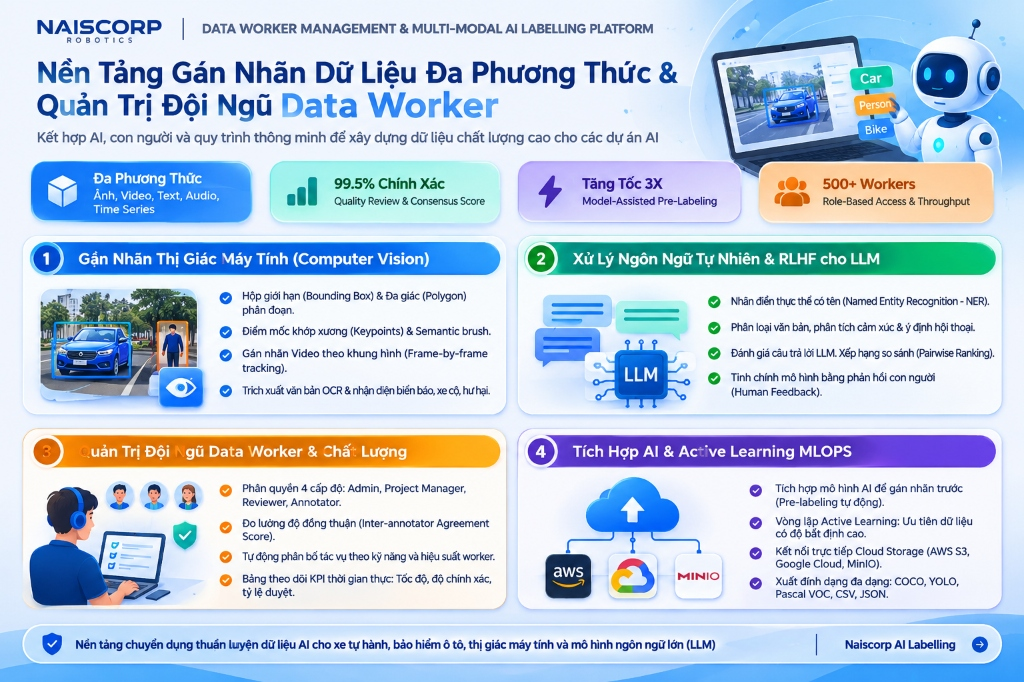
- Gán nhãn đa phương thức (Multi-Modal): Hỗ trợ đầy đủ các định dạng hình ảnh, video đa khung hình, văn bản, âm thanh dạng sóng và dữ liệu chuỗi thời gian (time-series).
- Công cụ thị giác máy tính chuyên sâu: Cung cấp bộ công cụ Bounding Box, Polygon, Keypoints, Semantic Brush và Object Tracking phục vụ các bài toán AI xe tự hành và giám sát hư hại xe cơ giới.
- Quy trình RLHF cho mô hình ngôn ngữ: Đánh giá và xếp hạng câu trả lời của mô hình AI theo tiêu chuẩn phản hồi con người (Human Feedback), đánh dấu thực thể NER và phân loại cảm xúc.
- Quản trị đội ngũ Data Worker & Đo lường KPI: Phân quyền 4 cấp độ (Admin, Manager, Reviewer, Annotator), tự động phân phối tác vụ, theo dõi năng suất và xếp hạng worker thời gian thực.
- Kiểm định chất lượng & Độ đồng thuận (Consensus): Tính điểm đồng thuận giữa nhiều annotator trên cùng mẫu dữ liệu, quy trình kiểm duyệt 2 vòng đảm bảo độ chính xác vượt trội > 99.5%.
- Tăng tốc với Model-Assisted & Active Learning: Tích hợp các mô hình AI để gợi ý nhãn tự động (Pre-labeling), giúp giảm hơn 60% thời gian thao tác thủ công của nhân viên.
Bản đồ tính năng gán nhãn đa phương thức & Quản trị Worker
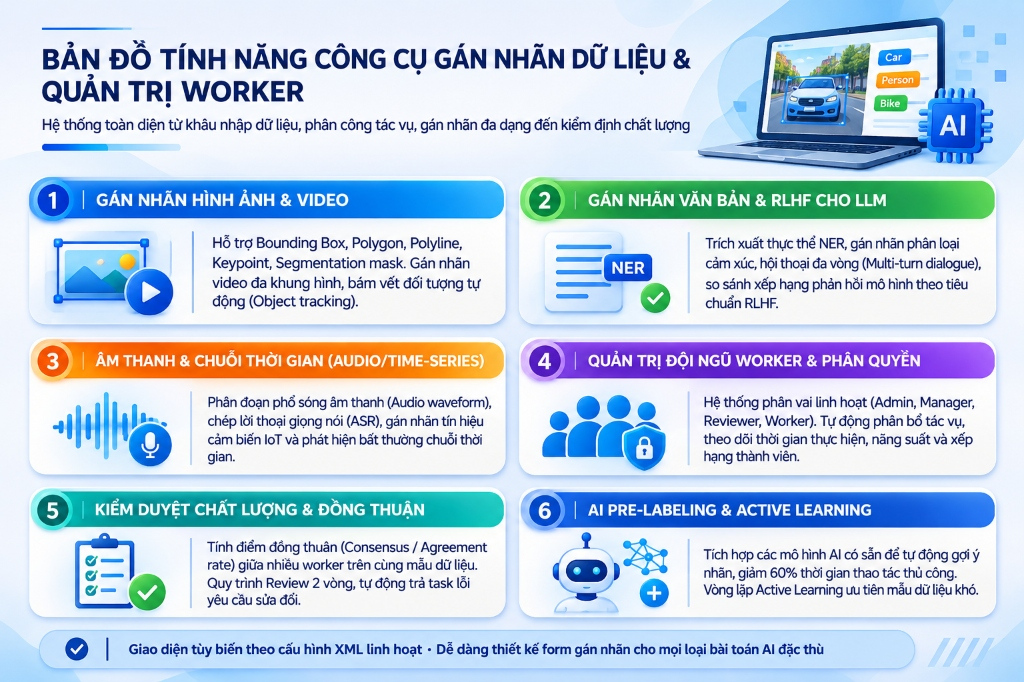
Hệ sinh thái tính năng được thiết kế đáp ứng mọi nhu cầu chuẩn hóa dữ liệu từ cấp độ nghiên cứu đến dự án quy mô doanh nghiệp:
| Tính năng cốt lõi | Chi tiết hoạt động | Giá trị mang lại |
|---|---|---|
| Gán nhãn thị giác máy tính | Hỗ trợ hộp giới hạn (Bounding box), đa giác (Polygon), đường đa đoạn (Polyline), điểm khớp xương (Keypoint), cọ phân đoạn ngữ nghĩa (Semantic brush) và theo dõi đối tượng trên video đa khung hình. | Phục vụ chính xác các bài toán huấn luyện AI xe tự hành, phát hiện hư hại xe ô tô bảo hiểm và camera giám sát an ninh. |
| Gán nhãn văn bản & RLHF cho LLM | Đánh dấu thực thể có tên (NER), phân loại sắc thái cảm xúc, gán nhãn intent hội thoại đa vòng, so sánh xếp hạng cặp câu trả lời (Pairwise ranking) phục vụ tinh chỉnh LLM. | Tạo lập bộ dữ liệu chất lượng cao cho chatbot doanh nghiệp, trợ lý ảo và huấn luyện mô hình ngôn ngữ lớn an toàn. |
| Xử lý âm thanh & Chuỗi thời gian | Hiển thị phổ sóng âm (Audio waveform) để phân đoạn giọng nói, chép lời thoại (ASR), đánh dấu bất thường trên tín hiệu cảm biến IoT và dữ liệu chuỗi thời gian. | Tối ưu hóa cho các hệ thống nhận diện giọng nói tiếng Việt đa vùng miền và dự đoán bảo trì thiết bị công nghiệp. |
| Quản trị đội ngũ Data Worker | Phân quyền 4 cấp độ (Admin, Project Manager, Reviewer, Annotator). Tự động phân bổ tác vụ theo kỹ năng, đo lường năng suất (nhãn/giờ) và thời gian thực hiện. | Vận hành trơn tru đội ngũ hàng trăm worker cùng lúc, phân phối khối lượng công việc công bằng và minh bạch. |
| Kiểm soát chất lượng & Độ đồng thuận | Tính toán ma trận đồng thuận (Inter-annotator agreement score / Consensus) giữa các worker trên cùng mẫu dữ liệu. Quy trình kiểm duyệt 2 vòng, tự động trả task lỗi. | Đảm bảo độ chính xác của tập dữ liệu huấn luyện đạt trên 99.5%, loại bỏ hoàn toàn các sai số do định kiến chủ quan. |
| Gợi ý nhãn AI & Active Learning | Tích hợp mô hình AI suy luận trước (Pre-labeling) để worker chỉ cần kiểm tra và tinh chỉnh. Vòng lặp Active Learning ưu tiên mẫu dữ liệu có độ bất định cao. | Giảm tới 60% thời gian gán nhãn thủ công, đẩy nhanh chu kỳ huấn luyện và tái triển khai mô hình AI trong sản xuất. |
Kiến trúc hệ thống & MLOps Pipeline
Nền tảng được xây dựng theo kiến trúc phân tán microservices chịu tải cao, tích hợp liền mạch vào quy trình MLOps:
- Tầng lưu trữ & Thu thập dữ liệu (Data Ingestion):
- Tích hợp trực tiếp với các kho lưu trữ đám mây chuẩn doanh nghiệp (AWS S3, Google Cloud Storage, MinIO).
- Hỗ trợ tải dữ liệu theo lô lớn, phân chia tập train/val/test và quản lý phiên bản dữ liệu (Data Versioning).
- Tương thích xuất/nhập đa định dạng: COCO JSON, Pascal VOC XML, YOLO TXT, CSV và JSON-Lines.
- Tầng không gian gán nhãn (Annotation Workspace Engine):
- Khung vẽ đồ họa 2D/3D tối ưu phần cứng (Canvas GPU accelerated), hỗ trợ phóng to vô hạn, phím tắt thao tác nhanh.
- Trình hiển thị sóng âm thanh tương tác và giao diện đánh dấu thực thể văn bản hỗ trợ tô màu đa nhãn.
- Cấu hình form gán nhãn linh hoạt thông qua cú pháp thẻ XML tùy biến, dễ dàng thiết lập theo từng bài toán riêng biệt.
- Tầng quản trị luồng công việc & Chất lượng (Quality Control Engine):
- Hàng đợi phân phối tác vụ thông minh (Smart Task Queue) cân bằng tải công việc tự động giữa các worker online.
- Bộ tính toán điểm đồng thuận đa chiều đánh giá sự trùng khớp về tọa độ bounding box (IoU) và nhãn văn bản.
- Hệ thống Review 2 lớp: Chuyên viên kiểm tra ngẫu nhiên hoặc kiểm duyệt toàn phần trước khi xuất dataset.
- Tầng tích hợp mô hình AI & Vòng lặp phản hồi (Active Learning):
- Kết nối backend ML qua API RESTful, tự động gọi mô hình AI suy luận nhãn sơ bộ cho các task mới nạp vào.
- Vòng lặp Active Learning tự động chọn lọc các mẫu dữ liệu mô hình chưa tự tin để chuyển giao cho worker gán nhãn bổ sung.
Mẫu giao diện và quy trình làm việc thực tế
Minh họa trải nghiệm thực tế của công cụ gán nhãn đa phương thức qua không gian làm việc gán nhãn ảnh, màn hình tinh chỉnh RLHF cho LLM và bảng quản trị năng suất đội ngũ Data Worker:
Bảng quản trị danh sách tác vụ và theo dõi tiến độ của đội ngũ Data Worker trong dự án:
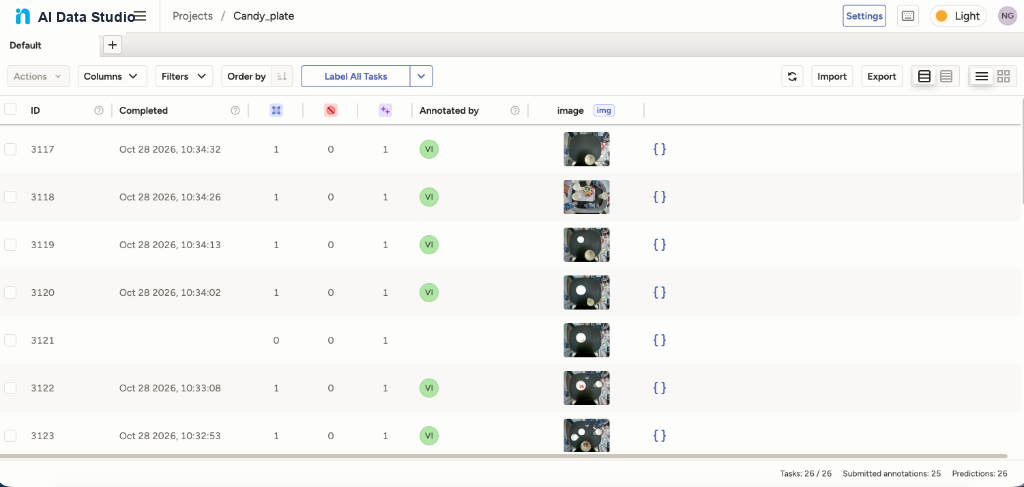
- Bảng quản lý tác vụ tập trung (Task List & Queue): Theo dõi trực quan trạng thái từng tác vụ theo ID, mốc thời gian hoàn thành, số lượng nhãn và định danh worker phụ trách.
- Bộ lọc và thao tác dữ liệu hàng loạt: Hỗ trợ lọc theo trạng thái gán nhãn, phân bổ tác vụ tự động (Label All Tasks), và xuất nhập đa định dạng.
Không gian làm việc gán nhãn thị giác máy tính với tính năng so sánh trực tiếp kết quả dự đoán của mô hình AI:
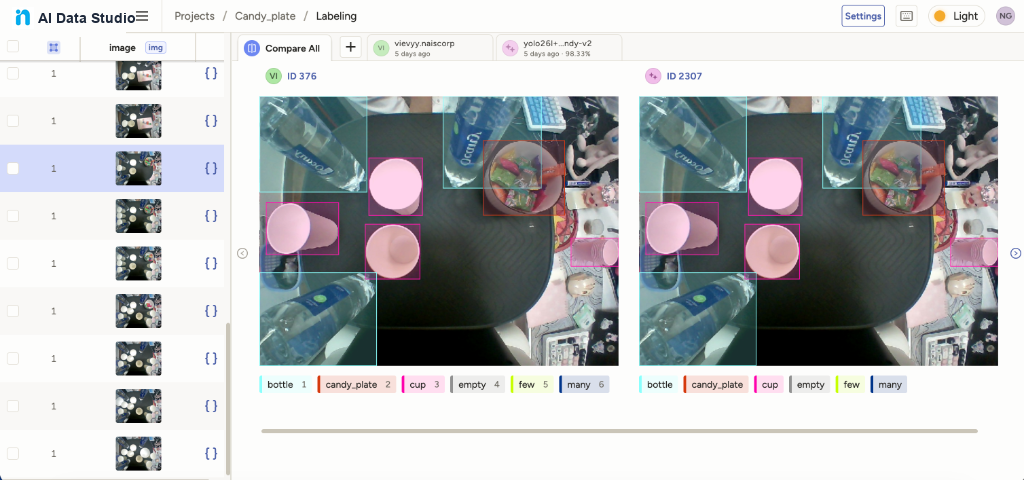
- Chế độ đối chiếu song song (Compare All Mode): So sánh trực tiếp giữa kết quả gán nhãn của Data Worker và nhãn dự đoán tự động từ mô hình AI (Model Pre-labeling).
- Bộ công cụ Bounding Box trực quan: Đánh dấu chuẩn xác từng đối tượng với màu sắc phân biệt và hệ thống phím tắt số giúp tăng tốc độ gán nhãn.
- Vòng lặp tối ưu Active Learning: Dễ dàng rà soát độ lệch giữa mô hình và worker, hiệu chỉnh tức thì để bổ sung dữ liệu huấn luyện chất lượng cao.